
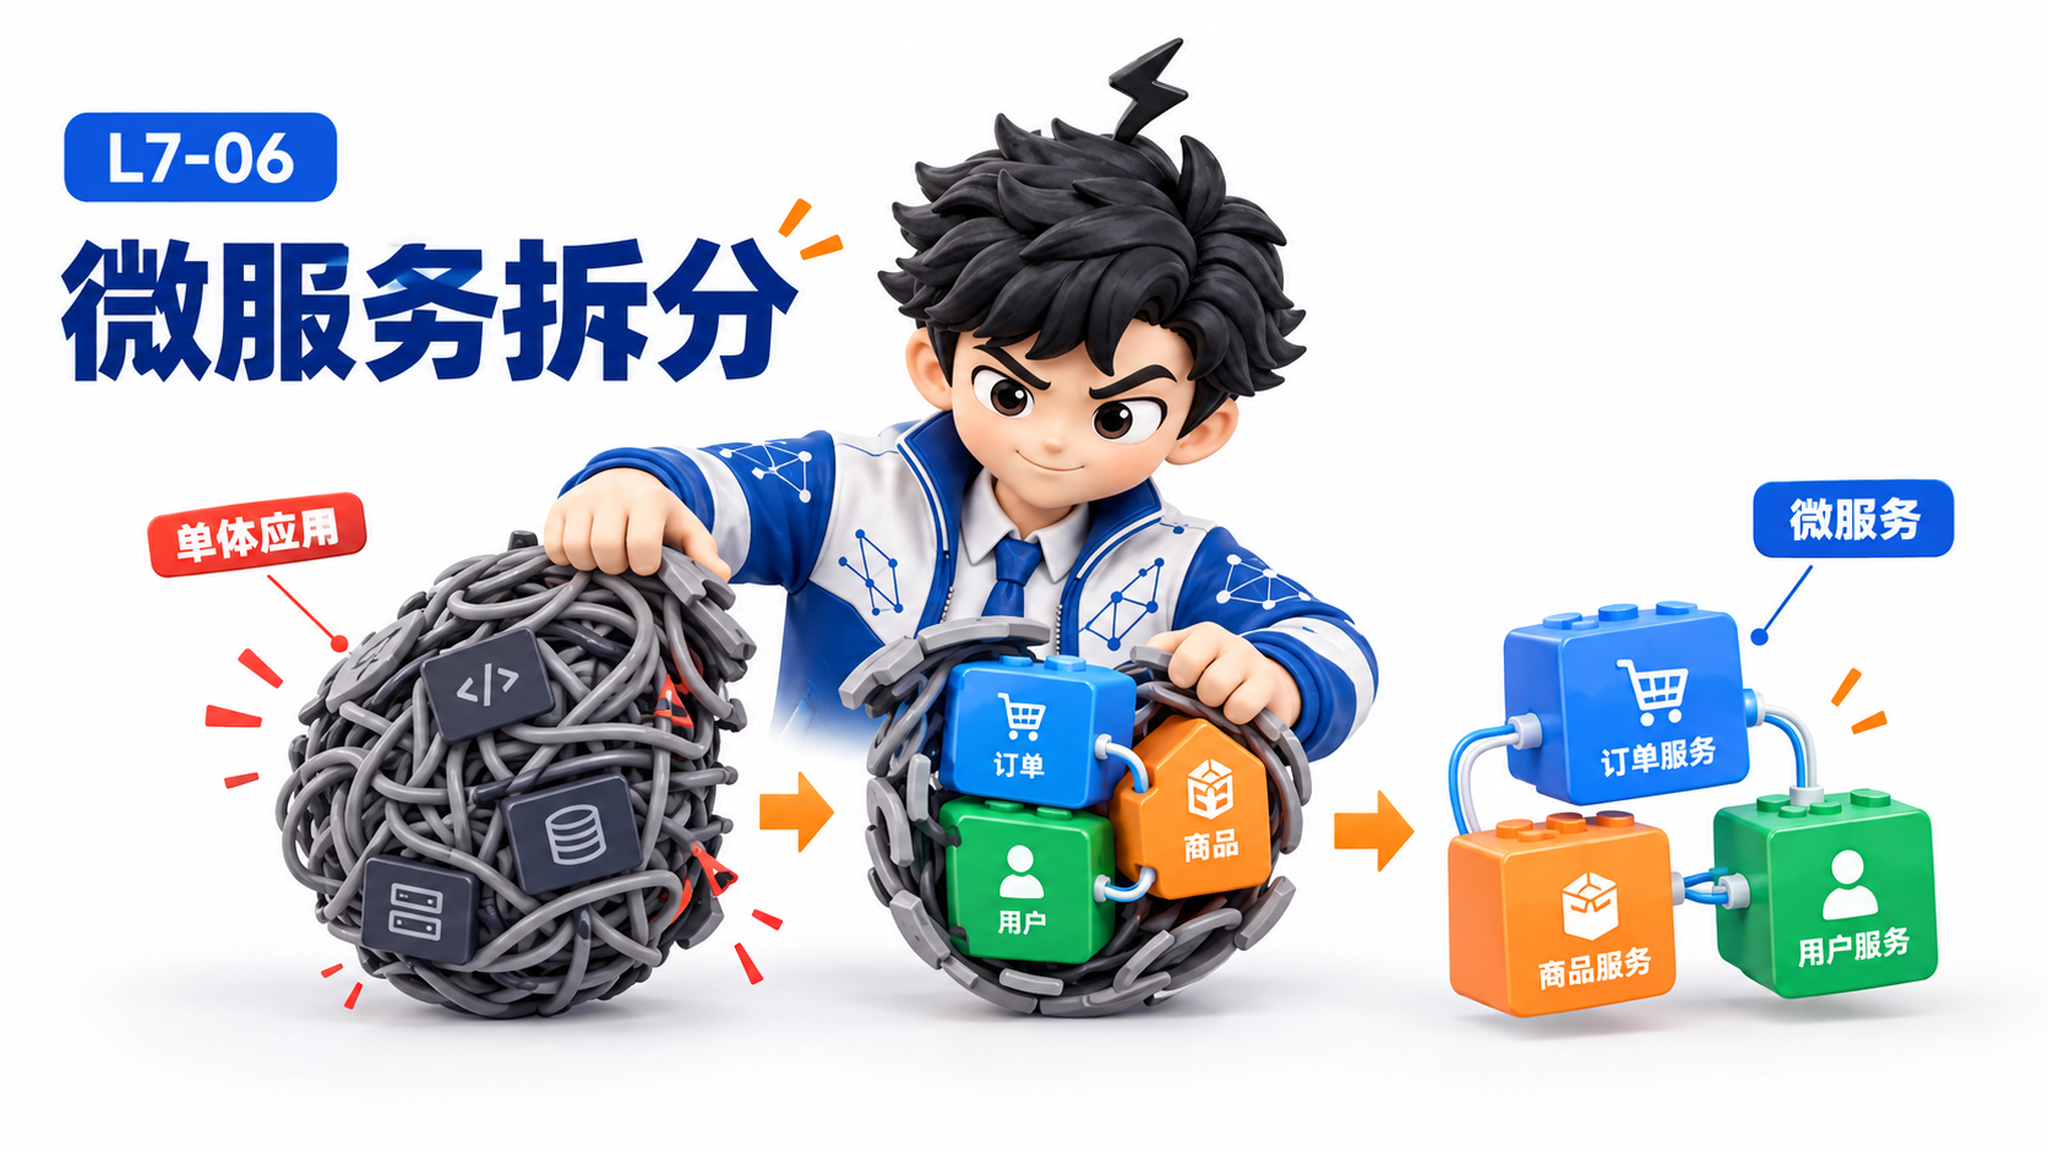
🎯 学微服务拆分的工程实践:不是"拆得越细越好",而是从领域边界识别、服务粒度决策、数据拆分策略、通信模式选择到渐进式迁移的完整方法。 ⏱️ 预计时间:45 分钟
[!tip] 💡 白话小课堂 微服务拆分不是"拆得越细越好"。把一个大应用想象成乐高——拆得好像乐高积木(模块独立、可以任意组装),拆得不好像打碎的玻璃(满地碎片、互相依赖、无法独立运作)。核心原则:按业务领域拆(订单、商品、支付),而不是按技术层拆(前端、后端、数据库)。按技术层拆=每次改一个业务需求都要动所有层。
[!warning] ⚠️ 避坑指南 四个最常见的"拆早了的后悔":1)团队<5人就拆分——沟通成本低于分布式系统成本,单体能搞定;2)产品没验证就拆分——业务逻辑还在快速变化,拆了反而束缚手脚;3)因为"将来可能需要扩展"而拆——YAGNI原则,等真的需要再拆;4)只拆代码不拆数据——共享数据库的微服务不是真正的微服务,数据耦合比代码耦合更难解。
[!info] 🔑 核心秘诀 绞杀者模式(Strangler Fig)是拆分单体最安全的策略:新旧系统共存→逐步切流量→验证稳定→退役旧代码。就像给飞行中的飞机换引擎——不能停机,每次只换一个部件。永远不要搞"大爆炸式迁移"——关闭旧系统、启动新系统——那是一场赌博,99%会输。
[!quote]- 📖 课程来源 本课为系统设计大师课,内容综合自真实电商工程实践经验,而非单一 Skill 文件。涵盖架构设计、分布式系统、团队管理等高级工程主题。
1. 微服务的真相——不是银弹
单体 vs 微服务——真实的权衡
单体的真实优势
→ 开发简单:一个 IDE 打开,全局搜索,一键调试 → 事务简单:ACID 事务天然支持 → 部署简单:一个 artifact,一次部署 → 重构简单:跨模块重构无网络边界
微服务的真实代价
→ 网络延迟:每次 RPC 增加 1-10ms → 分布式事务:需要 Saga、TCC、最终一致性 → 调试困难:一个请求跨 5 个服务,需要分布式追踪 → 运维复杂:监控、日志、CI/CD 都变复杂 → 数据一致性:这是最难的部分
什么时候不该拆?
→ 团队 < 5 人:沟通成本 < 分布式系统成本 → 产品未验证:业务逻辑还在快速变化 → 数据强一致:支付/库存需要 ACID 事务 → 性能未达瓶颈:单体 + 读写分离往往够用
什么时候该拆?
→ 团队 > 20 人:不同团队需要独立交付 → 独立扩展需求:搜索和下单需要不同的扩容策略 → 不同变更速率:核心支付年变更 10 次,营销活动周变更 3 次 → 故障隔离:非核心功能挂了不能影响下单
2. 拆分方法论——DDD 边界驱动
用领域驱动设计(DDD)指导拆分
Step 1: 识别限界上下文(Bounded Context)
不是按技术层拆,是按业务领域拆:
❌ 错误拆分(技术层): → user-service(只做 CRUD) → order-service(只做 CRUD) → product-service(只做 CRUD) 问题:业务逻辑散落在三个服务间,一个业务操作需要协调三个服务
✓ 正确拆分(业务领域): → 订单上下文:创建订单、订单状态、订单查询 → 商品上下文:商品管理、类目、属性、上下架 → 用户上下文:注册登录、会员等级、收货地址 → 支付上下文:支付、退款、对账 → 物流上下文:发货、物流追踪、签收 → 营销上下文:优惠券、满减、秒杀、推荐
Step 2: 识别聚合(Aggregate)
每个限界上下文内,找出聚合根: → 订单上下文:Order(聚合根),OrderItem(实体),OrderAddress(值对象) → 聚合规则:对 Order 的修改通过 Order 聚合根 → 保证一致性边界 → 聚合之间:只能通过 ID 引用,不能直接持有对象引用
Step 3: 数据拆分(最难的部分)
每个服务有自己的数据库: → Order DB:订单表、订单明细表 → Product DB:商品表、SKU 表、库存表 → User DB:用户表、地址表 → Payment DB:支付记录表、退款表
跨服务数据访问——三种模式:
→ API 同步调用:Order → GET /products/{id}(简单,耦合)
→ 数据复制(CQRS):Product 变更事件 → Order 同步商品快照(解耦,有延迟)
→ 数据聚合服务(BFF):Backend for Frontend 聚合多服务数据
3. 通信模式选择
同步 vs 异步——决策框架
同步通信(REST / gRPC)
适用场景: → 读操作:查询商品详情(需要实时准确数据) → 强依赖:下单前必须校验库存 → 低频调用:用户登录(QPS < 100)
防护措施: → 超时(timeout):2-5 秒 → 重试(retry):最多 3 次,指数退避 → 熔断(circuit breaker):失败率 > 50% → 快速失败 → 舱壁(bulkhead):限制并发连接数
异步通信(消息队列 / Kafka)
适用场景: → 通知类:订单创建后发邮件/短信 → 数据同步:商品上架后同步到搜索索引 → 解耦场景:订单支付成功后通知积分服务 → 削峰填谷:秒杀请求先入队列
可靠性保证: → 至少一次投递(at-least-once)+ 消费者幂等 → 死信队列(DLQ):处理失败的消息 → 人工排查 → 消息顺序:同一实体的消息发到同一 partition
事件驱动(推荐)
大多数跨服务协作应该用事件: → OrderCreated → Inventory Service(扣库存) → OrderCreated → Payment Service(发起支付) → OrderCreated → Notification Service(发邮件) → PaymentCompleted → Logistics Service(创建运单)
4. 渐进式迁移——从不停止业务
Strangler Fig Pattern(绞杀者模式)
Phase 1: 共存期
单体 + 新服务并行运行: → 路由层(API Gateway)按路径转发 → /api/v1/orders → 单体 → /api/v2/orders → order-service
Phase 2: 数据同步期
新服务需要单体中的历史数据: → 全量同步:ETL 一次性迁移历史数据 → 增量同步:CDC(Change Data Capture)→ Kafka → 新服务消费 → 回写:新服务的写入 → 同时写到单体 DB(双向同步过渡)
Phase 3: 分流期
逐步切流量: → 5% → 新服务(灰度验证) → 25% → 扩大范围 → 100% → 完全切换 → 每一步都观察:错误率、延迟、业务指标
Phase 4: 退役期
确认新服务稳定运行 > 2 周: → 旧代码标记 @deprecated → 再等 1 周 → 拆掉数据同步桥 → 删除旧代码 → 庆祝 🎉
5. 电商案例:从Rails单体到微服务架构的渐进式拆分
🛒 实战案例:某电商平台3年历史的Rails单体应用,代码量12万行、35张表,日订单从最初的300单增长到2万单。增长带来的痛苦:(1)部署从5分钟膨胀到32分钟(全量回归测试+asset预编译),(2)数据库连接池频繁耗尽(营销活动的高并发SQL与正常下单SQL抢锁),(3)任何一个小改动都可能引发意想不到的连锁故障(上个月改优惠券逻辑导致购物车页面502)。团队从最初的5人扩张到18人,但交付速度反而下降。
用 gstack 架构体系指导拆分:
- /office-hours 质疑拆分动机 → CTO说"部署慢+数据库扛不住所以拆微服务"→ gstack追问:"部署慢的根本原因是全量回归测试25分钟,拆微服务后每个服务独立测试+集成测试总时间可能更长;数据库扛不住的原因是秒杀SQL和正常下单SQL抢锁,把秒杀库存移到Redis就能解决——不需要拆分整个系统。"结论:先拆最大痛点最小范围——营销模块(每周变更3次,最高频,故障影响最大)
- /plan-eng-review 评审具体拆分方案 → 营销服务独立部署(复用Ruby不换语言,降低学习成本),独立DB(coupons/flash_sales/recommendations三张表),与单体通过REST(读商品数据带5分钟缓存)+ Kafka(写订单事件)通信
- /review 审查迁移代码 → 发现4个CRITICAL:(1)CDC配置使用statement-based replication→UPDATE coupons SET used_count=used_count+1在主从间产生不一致→修复:改用row-based replication;(2)数据迁移脚本无事务包裹→50万行迁移到一半失败无回滚→修复:每1000行一个事务+checkpoint;(3)新旧服务双向写无冲突解决→修复:过渡期新服务写、单体只读;(4)API超时30s→营销服务调用单体商品API超时太长→修复:3s超时+熔断+fallback到缓存
- Strangler Fig渐进式迁移:Week 1-2新服务共存+数据同步 → Week 3全量迁移+CDC验证 → Week 4-5灰度切流(10%→50%→100%)→ Week 6确认稳定后退役旧代码
效果:
营销模块部署时间从32分钟(全量单体)降至2分钟(独立服务),部署频率从每周1次→每天3次
故障隔离:营销服务某次OOM→仅影响领券功能,下单和浏览商品完全正常(之前:营销bug→全站502)
数据库连接池:单体峰值从85降至55(减少35%),营销服务独立连接池峰值15
团队交付速度恢复:18人团队月交付功能点从拆分前的28个恢复到52个
此次拆分验证了微服务的价值——接下来按相同模式拆支付模块(同样高变更频率+高隔离需求),但不拆商品/用户模块(变更频率低,单体够用)
🔑 启示:微服务拆分的第一原则不是"怎么拆",而是"为什么要拆"——必须有一个具体的、可量化的痛点作为驱动力(部署慢多少分钟?哪个模块变更频率高?哪个故障影响了多少订单?),而不是"微服务很流行"。第二原则:拆最小的、变更最频繁的模块先验证——用最小成本回答"微服务对我们团队到底值不值得"。绞杀者模式的核心安全保证:任何时候至少有一个系统拥有"完整且正确的数据"(单体作为source of truth),在新服务稳定运行>2周之前绝不删除旧代码。
6. 动手实践
- 用 DDD 方法画限界上下文图:拿你当前的电商系统(或一个假设的系统),画出至少 5 个限界上下文(如订单、商品、用户、支付、物流),标注每个上下文的聚合根和实体。
- 识别一个可拆分的模块:从你的单体系统中找一个"修改频率高、与核心流程耦合度低"的模块(如通知服务、推荐服务),写一份拆分方案:拆分后的接口、数据归属、通信方式。
- 设计 Strangler Fig 迁移步骤:为上述模块设计 4 步迁移计划——第 1 步不改代码只建新服务、第 2 步双写、第 3 步切换流量、第 4 步下线旧代码。标注每一步的风险和回滚方案。
[!tip] 提示:拆分的驱动力不是"微服务很酷",而是"这个模块的独立部署/独立扩展/独立团队维护能带来真实的业务价值"。如果不确定该不该拆——就别拆。
7. 掌握检验
Q1:微服务的三个真实代价中,哪一个对开发效率影响最大且最容易被低估?
- A) 需要更多服务器
- B) 数据一致性——单体中 ACID 事务天然可用,微服务中需要 Saga/TCC/最终一致性,这是"最难的部分"
- C) 需要更多编程语言
- D) 需要更多 Git 仓库
Q2:DDD 的限界上下文为什么比按技术层拆分更合理?请用一个具体的电商业务需求(如"用户下单后查看订单详情")说明:按技术层拆(user-service/order-service/product-service 做 CRUD)和按业务领域拆(订单上下文包含创建订单、状态流转、查询的完整逻辑)在该需求上的实现差异和团队协作差异。
Q3:同步通信(REST/gRPC)和异步通信(消息队列/Kafka)各自适用什么场景?请根据以下四个场景分类并说明选择理由:(a) 查询商品详情页展示实时价格和库存;(b) 订单支付成功后发送通知短信;(c) 商品上架后同步到 Elasticsearch 搜索索引;(d) 下单前校验库存是否充足。
Q4:Strangler Fig 模式的四个阶段中,哪一个阶段风险最高?如果在这个阶段出现问题(如新服务数据不一致),如何在不中断业务的情况下回退?
- A) Phase 1 共存期——新旧系统同时运行可能导致数据冲突
- B) Phase 2 数据同步期——CDC 同步延迟或不一致可能导致新服务读到脏数据,且双向写存在冲突。回退方案:关闭新服务读流量(切回单体)但保留写同步,修复 CDC 问题后重新验证
- C) Phase 3 分流期——逐步切流量时容易发现问题
- D) Phase 4 退役期——删除旧代码可能会丢失功能
Q5:gstack /office-hours 在微服务拆分案例中对 Tech Lead 的"为什么要拆"提出了关键质疑——"数据库扛不住的原因只是营销活动的秒杀 SQL 和正常下单 SQL 抢锁,把秒杀库存移到 Redis 就能解决,不需要拆分整个系统"。请解释:这个质疑体现了什么工程决策原则?为什么 Tech Lead 最初想到的"拆成 10 个微服务"是错误的解法?
Q6:gstack /review 在拆分案例中发现"CDC 配置使用 statement-based replication"是 CRITICAL 问题。为什么 SBR 对 UPDATE coupons SET used_count = used_count + 1 不安全,而 RBR(row-based replication)安全?如果这个问题没被 /review 发现就上线,数据迁移期间会出现什么后果?
8. 答案
点击查看答案
Q1:B — 数据一致性是微服务最难的部分。单体中一个 ACID 事务涵盖订单创建→库存扣减→积分更新,要么全成功要么全回滚。微服务中这些被拆到不同服务的独立数据库,需要 Saga 补偿事务或 TCC,每个正向操作都要定义补偿操作,还需要处理补偿失败的情况。网络延迟(每次 RPC 增加 1-10ms)和运维复杂度(监控/日志/CI/CD 都变复杂)也是真实代价,但数据一致性是架构深度的最大挑战,出错直接导致业务数据错误。
Q2:按技术层拆(CRUD 微服务):用户请求"查看订单详情"→需要调用 user-service(取用户信息)+ order-service(取订单)→order-service 返回的 orderItems 只有 product_id→再调用 product-service(取商品详情)→前端或 BFF 层拼接。如果订单详情需要加"物流状态"字段,需要改 BFF 层+可能改 order-service+新增调用 logistics-service。按业务领域拆(订单上下文):订单上下文内部拥有 Order 聚合根→OrderItem 实体→OrderAddress 值对象。请求"查看订单详情"→订单服务一次性返回完整数据(内聚在订单上下文中)。新增"物流状态"字段→只需订单服务内部修改,因为物流信息是订单上下文的一部分。团队协作差异:技术层拆分导致任何业务功能都跨团队协调(前端团队等后端团队等数据团队),业务领域拆分则一个 Squad 内部独立完成。
Q3:(a) 查询商品详情页——同步通信(REST/gRPC),用户需要实时看到准确价格和库存,不能接受"5 分钟前的缓存"。防护:超时 2-3s、熔断、fallback 到缓存。(b) 支付成功发送通知——异步通信(消息队列/Kafka),通知是"告知"而非"依赖",发送失败不影响支付状态,可以重试。(c) 商品上架同步搜索索引——异步通信(Kafka),ES 索引更新允许短暂延迟(1-2s),且不应阻塞商品上架操作。可靠性:at-least-once + 消费者幂等。(d) 下单前校验库存——同步通信(gRPC),这是强依赖——库存不足则下单必须失败,不能用异步(否则用户看到"下单成功"但实际已售罄)。
Q4:B — Phase 2 数据同步期风险最高,因为新旧系统之间存在"脑裂"风险:(1) CDC 同步延迟→新服务读到旧数据;(2) 双向写冲突→新旧服务同时写同一行→后写者覆盖先写者。回退方案不中断业务:Step 1 关闭新服务的读流量(所有读切回单体)→Step 2 关闭新服务的写路径(只保留单向同步:新服务→单体,确认无数据丢失)→Step 3 修复 CDC 问题→Step 4 验证数据一致性→Step 5 重新开启双向同步。核心原则:任何时候至少有一个系统拥有"完整且正确"的数据(通常是单体作为 source of truth)。
Q5:体现了"先诊断再开处方"和"最小干预原则"。Tech Lead 最初的问题是"部署慢+数据库扛不住",就直接套用了"拆成微服务"这个流行方案,没有追问根因。gstack 的分析:(1) 部署慢的真正原因是全量回归测试 25 分钟,拆分微服务后每个服务独立测试+集成测试总时间可能更长;(2) 数据库扛不住的真正原因是秒杀 SQL 和正常下单 SQL 抢锁,只需把秒杀库存移到 Redis 就能解决。拆成 10 个微服务引入了分布式系统的全部复杂度(网络延迟、分布式事务、调试困难),且没有针对性解决任何原始问题。正确策略:先拆最大痛点最小范围(营销模块),验证价值后再决策。这就是"不要用微服务解决单体解决的问题"的工程原则。
Q6:SBR 记录 SQL 语句本身(如 UPDATE coupons SET used_count = used_count + 1),不记录修改前后的具体行数据。非确定性函数(NOW()、RAND()、自增/自减操作)在从库重放时可能产生不同的结果——因为从库的时序、锁竞争、CPU 时间片与主库不同,used_count 的最终值可能不一致。RBR 记录每行修改前后的实际值,在从库直接应用这些值,与主库结果完全一致。如果不修复就上线:营销活动的优惠券使用次数可能在主库和从库(新服务 DB)之间逐渐漂移——主库显示已使用 100 次,新服务 CDC 同步显示已使用 99 次——差异持续累积,最终导致优惠券超发或用户投诉"我有券为什么不能用"。
(5/6 通过)
延伸阅读
- [[L7-05-搜索推荐双引擎|上一课:搜索推荐双引擎 —— 让用户3秒内找到他都不知道自己想要的东西]]
- [[L7-07-分布式数据一致性|下一课:分布式数据一致性 —— 钱和库存永远对得上的工程方法]]
- [[L7-02-事件驱动架构|相关:事件驱动架构——微服务通信基础]]
评论区
共 0 条评论