
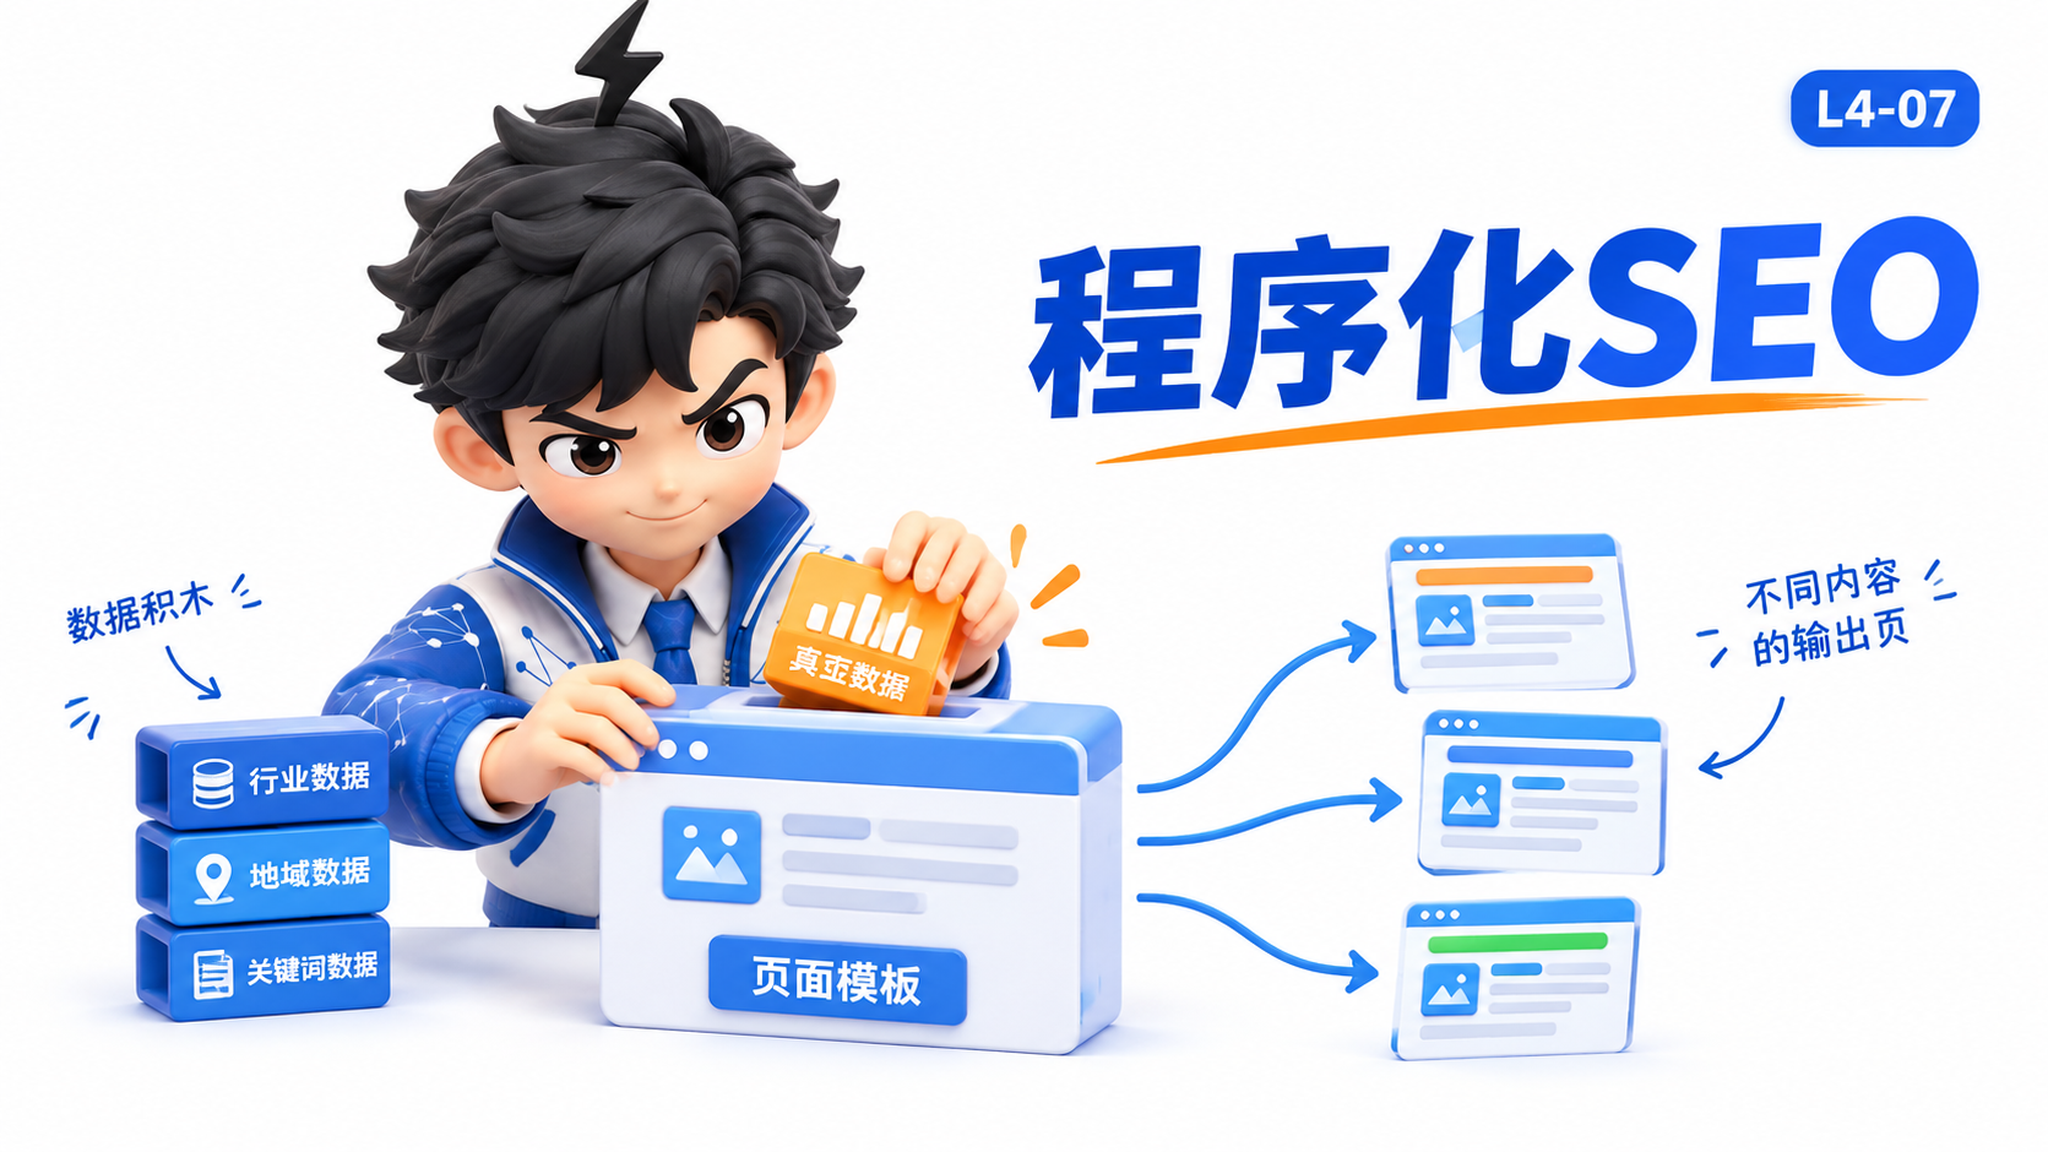
🎯 学什么:学会用模板和数据成批生成SEO页面——用一个模板,填入不同的真实数据,生成成千上万个有独特价值的页面。核心矛盾:要批量生产页面,但每页必须有独特价值——Google惩罚"薄内容"(只是换了城市名的相同页面)。用三层内容设计(基础层/数据层/洞察层)解决这个矛盾,用12种已验证玩法匹配不同业务场景,用专有数据建立竞争护城河。核心洞察:Google不恨程序化页面——Google恨的是"没有独特价值的程序化页面"。 💡 难易度:⭐⭐⭐ | ⏱️ 预计时间:45 分钟
1. 课程概览
💡 白话小课堂:这个 Skill 就像一个房产中介的房源册子——册子里每一页都是同样的模板("XX小区,X室X厅,XX平米,XX万"),但数据是真实的、独特的。这就是程序化SEO:用一个模板,填入不同的真实数据,生成成千上万个有独特价值的页面。Zapier有10万+集成页面(如"Slack+Asana集成"),每个页面都有独特的功能描述、设置步骤、使用案例——Google不但不惩罚,还给它们大量排名。
本课的独特定位——规模化建站型 Skill:
| 特征 | L3-10(SEO审计) | L4-07(本课) |
|---|---|---|
| 核心问题 | 诊断现有网站的SEO问题 | 如何批量生成有独特价值的SEO页面 |
| 页面数量 | 优化已有页面 | 从0到10万+页面的策略 |
| 关键杠杆 | 逐页审计 | 模板+数据+洞察三层设计 |
🔑 核心秘诀:专有数据是程序化SEO的护城河。如果你的数据其他网站也能轻易拿到,那Google何必把你的页面排前面?但如果你自己收集了"全北京3827个小区的房价变动数据"——其他网站没有,Google就只能排你。
⚠️ 避坑指南:内链是最容易被跳过的步骤。生成了10万个页面但每个页面只有一条内链(从Hub页过来)——Google会觉得这些页面不重要。
来源:Corey Haines marketingskills(
coreyhaines31/marketingskills --skill programmatic-seo)
2. 程序化SEO的核心矛盾与三层设计
2.1 pSEO悖论
矛盾:要批量生产页面,但每页必须有独特价值。

Google惩罚的是:薄内容页面
  → 10,000个页面,每个页面的文字完全一样,只换了城市名
  → "北京瑜伽馆""上海瑜伽馆""深圳瑜伽馆"——除了地名,全都一样
  → 结果:整个目录被降权或de-index

Google不惩罚的是:有独特价值的程序化页面
  → Zapier有10万+集成页面,每个页面都有:
    - 该集成的独特功能描述
    - 该集成的设置步骤
    - 该集成的使用案例
    - 用户评价和常见问题
  → 模板一样,但内容独特

解决方案:三层内容设计
2.2 三层内容设计
基础层(Foundation Layer):模板驱动
  → 统一的页面模板
  → 标题模式、URL结构、布局骨架
  → 示例:标题"iPhone 15 在Shopee vs Lazada哪买最便宜(2024年X月)"

数据层(Data Layer):每页注入独特数据
  → 该页面独有的真实数据
  → 示例:该型号在各平台实时价格、历史最低价、用户评分、运费对比

洞察层(Insight Layer):条件性分析和原创见解⚠️ 成败关键
  → 基于数据层自动生成的"人话"分析
  → 示例:
    - 当前价 < 历史均价80% → "现在是入手好时机"
    - 某平台比均价低15%+ → "全网最低价在XX平台"
    - 价格上升趋势 → "价格正在上涨,建议尽快购买"
    - 运费+商品总价仍比另一平台低 → "虽然标价高但免运费后更划算"

课程案例验证了洞察层的决定性作用:
  → 只有基础层+数据层:页面看起来基本一样,Google几乎不收录
  → 加上洞察层:收录率从12%跳升至87%
  → 独特的"人话"分析比独特的数字更重要
3. 12种已验证玩法
3.1 玩法总览
12种程序化SEO玩法(按防御性排序):

1. 模板页面(Templates):"简历模板""PPT模板""合同模板"
2. 策展/排行榜(Curation):"2024年最好的XX工具Top 10"
3. 转换器(Converters):"PNG转JPG""PDF转Word"
4. 对比页面(Comparisons):"XX vs YY——哪个更适合你?"
5. 示例库(Examples):"XX产品的使用案例""XX设计的灵感库"
6. 地域页面(Locations):"XX城市XX服务"(如"北京瑜伽馆")
7. 角色页面(Roles):"适合XX职位的XX工具"
8. 集成页面(Integrations):"XX + YY 集成"(Zapier模式)
9. 术语词典(Glossary):"XX是什么?""XX行业术语大全"
10. 翻译页面(Translations):多语言版本的相同内容
11. 目录/黄页(Directory):"XX行业的公司/产品列表"
12. 档案页面(Profiles):"XX公司/人物的详细档案"

玩法可以叠加!
  → "2024年深圳南山区最好的瑜伽馆" = Locations + Curation
  → "适合CTO的10大项目管理工具" = Roles + Curation
  → 叠加使用增加页面的独特性和搜索价值
3.2 玩法选择决策
你的业务有什么独特数据?

你有多个城市的数据 → Locations("XX服务在XX城市")
你有真实对比数据 → Comparisons("XX vs YY对比")
你有大量SKU/产品 → Templates/Curation("最佳XX推荐")
你有集成/合作伙伴 → Integrations(Zapier模式)
你有行业知识 → Glossary(术语词典、常见问题)

没有独特数据?
  → 从公开数据开始,但要知道:公开数据的防御性最低(任何人能做)
  → 尽快积累自己的专有数据——这是护城河
4. 数据防御性与技术实施
4.1 数据防御性层级
从高到低的防御性排序:

专有数据(Proprietary)⭐⭐⭐⭐⭐ —— 你自己创造的
  → 你从用户行为中提取的洞察
  → 你自己收集的调查数据
  → 你自己测量的指标
  → 示例:"我们分析了10万笔交易,发现XX是最佳购买时机"

产品衍生数据(Product-Derived)⭐⭐⭐⭐ —— 你的产品自然产生的
  → Zapier每个集成页面的功能描述来自实际集成数据
  → Shopify App Store的评论和评分

用户生成数据(UGC)⭐⭐⭐ —— 用户在你的平台上产生的
  → 评论、评价、上传的内容
  → 别人虽然也能做,但有先发优势

授权数据(Licensed)⭐⭐ —— 你花钱买的
  → 别人也可以花钱买同样的数据
  → 非独家

公开数据(Public)⭐ —— 任何人都能用
  → 政府公开数据、Wikipedia数据
  → 没有防御性——你做出来第二天竞品也做了
4.2 URL与内链架构
URL设计:
  → 使用子文件夹(/templates/resume/)而非子域名(templates.domain.com)
  → 原因:子文件夹合并域名权威(所有页面贡献给同一个域名权重)
          子域名分裂域名权威(相当于新站点从零积累权重)

内链模型:Hub-and-Spoke + Spoke-to-Spoke

❌ 只有Hub→Spoke:
   Hub页(所有城市的瑜伽馆)
    ↓     ↓     ↓
  北京   上海   深圳
  → 每个Spoke页只有1条内链 → Google觉得这些页面不重要

✅ Hub→Spoke + Spoke互链:
   Hub页
    ↓     ↓     ↓
  北京 ← → 上海 ← → 深圳
  → "看了北京的价格,你可能也关心上海和深圳的"
  → 每个页面多条内链 → Google认为页面有实质内容
  → Spoke互链用自然的关联(邻近城市、相似品类、可替代产品)
4.3 发布前检查清单
□ 每个页面的标题和元描述是否包含独特信息(不只是换了城市名)?
□ 每页至少包含3个数据点(不是只有模板文字)?
□ 每页有独特的"洞察"(即使只是条件性的一句话)?
□ URL使用子文件夹,全部小写,连字符分隔?
□ 内链到位:Hub→Spoke + Spoke互链(无孤儿页面)?
□ 所有页面已提交XML sitemap(按优先级分块,10,000页以上的用sitemap index)?
□ 抽样检查10个页面:有没有两个页面的内容超过80%相似?
5. 结构拆解:规模化建站型 Skill 模板
规模化建站型 Skill 模板
核心特征
→ 核心矛盾 = 批量生产 vs 每页独特价值(Google只惩罚薄内容) → 关键设计 = 三层内容(基础/数据/洞察)+ 12种玩法 + Hub-and-Spoke内链 → 护城河 = 专有数据最具防御性
通用结构
Three-Layer Content Design(三层内容设计)
基础层:模板(标题/URL/布局) 数据层:每页注入独特真实数据 洞察层:条件性分析和原创见解(收录率从12%→87%的关键)
12 Playbook Patterns(12种玩法)
Templates / Curation / Converters / Comparisons / Examples / Locations / Roles / Integrations / Glossary / Translations / Directory / Profiles 玩法可叠加(Locations + Curation = "XX城市最好的XX")
Data Defensibility(数据防御性)
Proprietary > Product-Derived > UGC > Licensed > Public
Technical Implementation(技术实施)
- URL:子文件夹 √ / 子域名 ✗
- 内链:Hub-and-Spoke + Spoke互链(无孤儿页面)
- XML sitemap:分块提交(超10,000页用sitemap index)
- 发布前检查清单:独特标题/3+数据点/洞察/内链
6. 电商案例:独立站宠物用品程序化SEO矩阵(1000+长尾页面)
🛒 实战案例:某Shopify独立站宠物用品品牌(主营猫抓板+猫爬架+猫玩具,客单价¥129-¥899),日自然流量仅420访客,月搜索点击约12,600次——几乎全部来自品牌词和"猫抓板"一个品类大词。核心问题:有27个SKU、15个猫咪行为场景、覆盖全国主要城市配送,但搜索引擎只收录了32个页面。
三层内容设计(以"猫抓板"品类为例):
| 层级 | 内容 | 策略 |
|---|---|---|
| 基础层 | 统一模板——标题"【2024实测】适合[猫咪品种]的[行为场景]猫抓板推荐(第X次更新)",页面结构:场景分析→产品对比→选购指南→真实买家反馈 | 一套模板覆盖27个SKU×15个场景×11个品种=4,455个页面组合 |
| 数据层 | 每种猫抓板的真实数据:材质(瓦楞纸/剑麻/实木)、尺寸(长宽高+重量)、耐久度(实测猫咪使用90天的磨损对比评分)、价格、用户评分、适合猫咪体重范围 | 所有数据来自自有产品实测和买家反馈,属于专有数据 |
| 洞察层 | (1) 如果猫体重>5kg且产品材质=瓦楞纸→"大型猫慎选,建议选剑麻或实木系列";(2) 如果该产品退货率<2%且评分>4.8→标注"实测推荐"徽章;(3) 如果用户评价中"猫咪不抓"出现>3次→"附赠猫薄荷诱导剂使用指南" |
长尾关键词页面矩阵设计:
| 页面类型 | 玩法 | 示例标题 | 目标关键词 | 生成数量 |
|---|---|---|---|---|
| 品种×场景 | Locations+Comparisons | "布偶猫用什么猫抓板?2024实测5款不伤毛的猫抓板" | "布偶猫 猫抓板 推荐" | 11品种×15场景=165页 |
| 场景×材质 | Comparisons | "沙发拯救计划:竖式vs横式vs转角猫抓板实测对比(附真实抓痕数统计)" | "竖式猫抓板 好用吗" | 15场景×3材质=45页 |
| 城市×价格 | Locations+Curation | "北京猫抓板实体店vs网购价格对比(2024年11月更新)" | "北京 猫抓板 哪里买" | 15城市×5品类=75页 |
| 问题解答型 | Glossary+Comparisons | "猫抓板几天就被抓烂了?4种材质耐久度实测排名" | "耐用的猫抓板" | 12篇深度问题对比 |
| 选购指南型 | Curation+Comparisons | "2024年度猫抓板TOP10:从¥29到¥899的真实测评" | "猫抓板 推荐 排行" | 5篇年度/季度榜单 |
| 细分品类对比 | Comparisons | "猫爬架自带猫抓柱 vs 独立猫抓板——哪个更值得买?" | "猫爬架 猫抓板 对比" | 8篇品类交叉对比 |
总计可生成:165 + 45 + 75 + 12 + 5 + 8 = 310个长尾关键词页面(首期),后续扩展到全部27个SKU×15个场景=405页
内链架构(Hub-and-Spoke + Spoke互链):
品类Hub页("猫抓板全品类选购指南")
  ├── 材质Hub("瓦楞纸vs剑麻vs实木猫抓板")
  │   ├── 瓦楞纸系列 ←→ 剑麻系列 ←→ 实木系列(Spoke互链)
  │   └── "看完剑麻的,你可能也关心瓦楞纸的价格对比"
  ├── 品种Hub("不同品种猫咪的猫抓板选择")
  │   ├── 布偶猫 ←→ 英短 ←→ 美短 ←→ 缅因(互链)
  │   └── "你家英短的体重偏大,缅因猫的推荐款可能也适合"
  └── 场景Hub("根据你家的空间选猫抓板")
      ├── 沙发区 ←→ 卧室 ←→ 阳台 ←→ 多猫家庭(互链)
      └── "如果你家是沙发杀手型猫咪,L型猫抓板的实测数据如下"
数据防御性:所有产品实测数据(材质耐磨度、猫咪使用频率、抓痕数量统计)均来自自购产品实验室测试+真实买家90天跟踪反馈——属于专有数据,竞品无法通过爬虫获取。
效果(上线6个月后):
- 收录页面从32页增至287页(首期310页中有287页被收录,收录率92.6%)
- 自然搜索流量 12,600次/月 → 58,000次/月(+360%)
- 长尾关键词排名:148个关键词进入Google前10、其中67个进入前3
- "布偶猫 猫抓板 推荐"排名第2,"耐用的猫抓板"排名第1(Featured Snippet)
- 自然搜索渠道GMV从¥1.2万/月增至¥8.7万/月
🔑 启示:独立站pSEO的关键不是"生成多少页面",而是"每个页面有没有真实数据支撑的独特判断"。猫抓板是典型的"信息不对称"品类——用户面对几十款产品不知所措,你的页面如果只是罗列参数等于没用。但如果你说"家有15斤布偶猫的实验员实测,这款瓦楞纸猫抓板第45天出现明显凹陷"——Google会奖励你,用户也会信任你。
7. 掌握检验
Q1:程序化SEO的核心矛盾是什么?Google为什么不惩罚Zapier的10万+集成页面但会惩罚"只换了城市名"的薄内容页面?
Q2:数据防御性从高到低的正确排序是?
- A) 公开数据 > 用户生成数据 > 专有数据 > 授权数据
- B) 专有数据 > 产品衍生数据 > 用户生成数据 > 授权数据 > 公开数据
- C) 用户生成数据 > 专有数据 > 公开数据 > 授权数据
- D) 授权数据 > 专有数据 > 公开数据 > 用户生成数据
Q3:为什么使用子文件夹(/templates/resume/)而非子域名(templates.domain.com)?
Q4:三层内容设计中,"洞察层"为什么是程序化SEO的成败关键?课程案例中,加入洞察层后收录率从多少提升到多少?
Q5:以下哪种内链架构最有利于程序化SEO页面的搜索引擎表现?
- A) 所有Spoke页面只链接回Hub页
- B) Hub→Spoke,Spoke之间也互链(Hub-and-Spoke + Spoke-to-Spoke)
- C) 所有页面互相链接(不分层级)
- D) Spoke页面之间不链接,避免"链接农场"
Q6:发布前检查清单中,"独特的标题和元描述"为什么对程序化页面尤其重要?如果1万个页面都是"XX城市XX服务"的模板化标题,会产生什么问题?
Q7:请为一个电商场景设计程序化SEO的三层内容策略: 你的平台覆盖Shopee/Lazada平台上的3C产品比价,数据库有500个品牌×每个品牌50个型号。
Q8:在12种已验证玩法中,如果你拥有多个城市本地服务商的真实报价数据,最应该选择哪种玩法?
8. 答案
点击查看答案
Q1:参考答案 — 核心矛盾:要批量生产页面,但每页必须有独特价值。Google惩罚的是"没有独特价值的程序化页面"。Zapier的成功在于每个集成页面都有独特的功能描述、设置步骤和使用案例——模板一样,但内容独特。只换城市名就是薄内容,必被惩罚。
Q2:B — 专有数据(你自己创造的)最具防御性,产品衍生数据次之,用户生成数据再次之,授权数据排第四,公开数据最弱(任何人都能用)。
Q3:参考答案 — 子文件夹合并域名权威(所有页面贡献给同一个域名的权重),子域名分裂域名权威(相当于一个新的独立站点从零开始积累权重)。用子文件夹是程序化SEO的最佳实践。
Q4:参考答案 — 洞察层是关键,因为光靠数据(价格数字)不够——页面看起来基本一样,Google几乎不收录。课程案例中,加入条件性洞察后("现在是入手好时机""全网最低"等),收录率从12%跳升至87%。独特的"人话"分析比独特的数字更重要。
Q5:B — Hub-and-Spoke + Spoke-to-Spoke模型。只用A会导致Google觉得Spoke页面不重要(只有一条内链)。C会显得像链接农场。D使页面成为孤儿。
Q6:参考答案 — 如果1万个页面的标题模板都长一样(只换了城市名),Google会判定为"大规模重复内容"(thin content),可能整个目录被降权或de-index。每个页面的标题和元描述应该包含该页面的独特信息——至少包含独特的数字、排名或洞察。
Q7:参考答案 —
- 基础层:统一的页面模板——标题"iPhone 15 在Shopee vs Lazada哪买最便宜(2024年X月)"、价格对比表、购买建议区
- 数据层:该型号在各平台实时价格、历史最低价及出现时间、各平台运费、用户评分和评论数、价格变动趋势
- 洞察层:(1) 当前价<历史均价80%→"现在是入手好时机";(2) 某平台比均价低15%+→突出"全网最低";(3) 价格上升趋势→"价格正在上涨,建议尽快购买";(4) 运费+商品总价仍比另一平台低→推荐该平台
Q8:参考答案 — Locations玩法("XX服务在XX城市"),因为你拥有多个城市的真实报价数据——这是专有数据,别人没有。可以叠加Curation玩法生成"2024年XX城市最便宜的XX服务Top 10",进一步增加页面独特性。
评分:答对 6/8 = 通过。
9. 延伸阅读
- [[L4-06-客户调研方法论|上一课:客户调研]] — 不问客户要什么,看他做什么
- [[L4-08-推荐裂变计划|下一课:推荐裂变引擎]] — 让1个用户带来10个新用户
评论区
共 0 条评论