
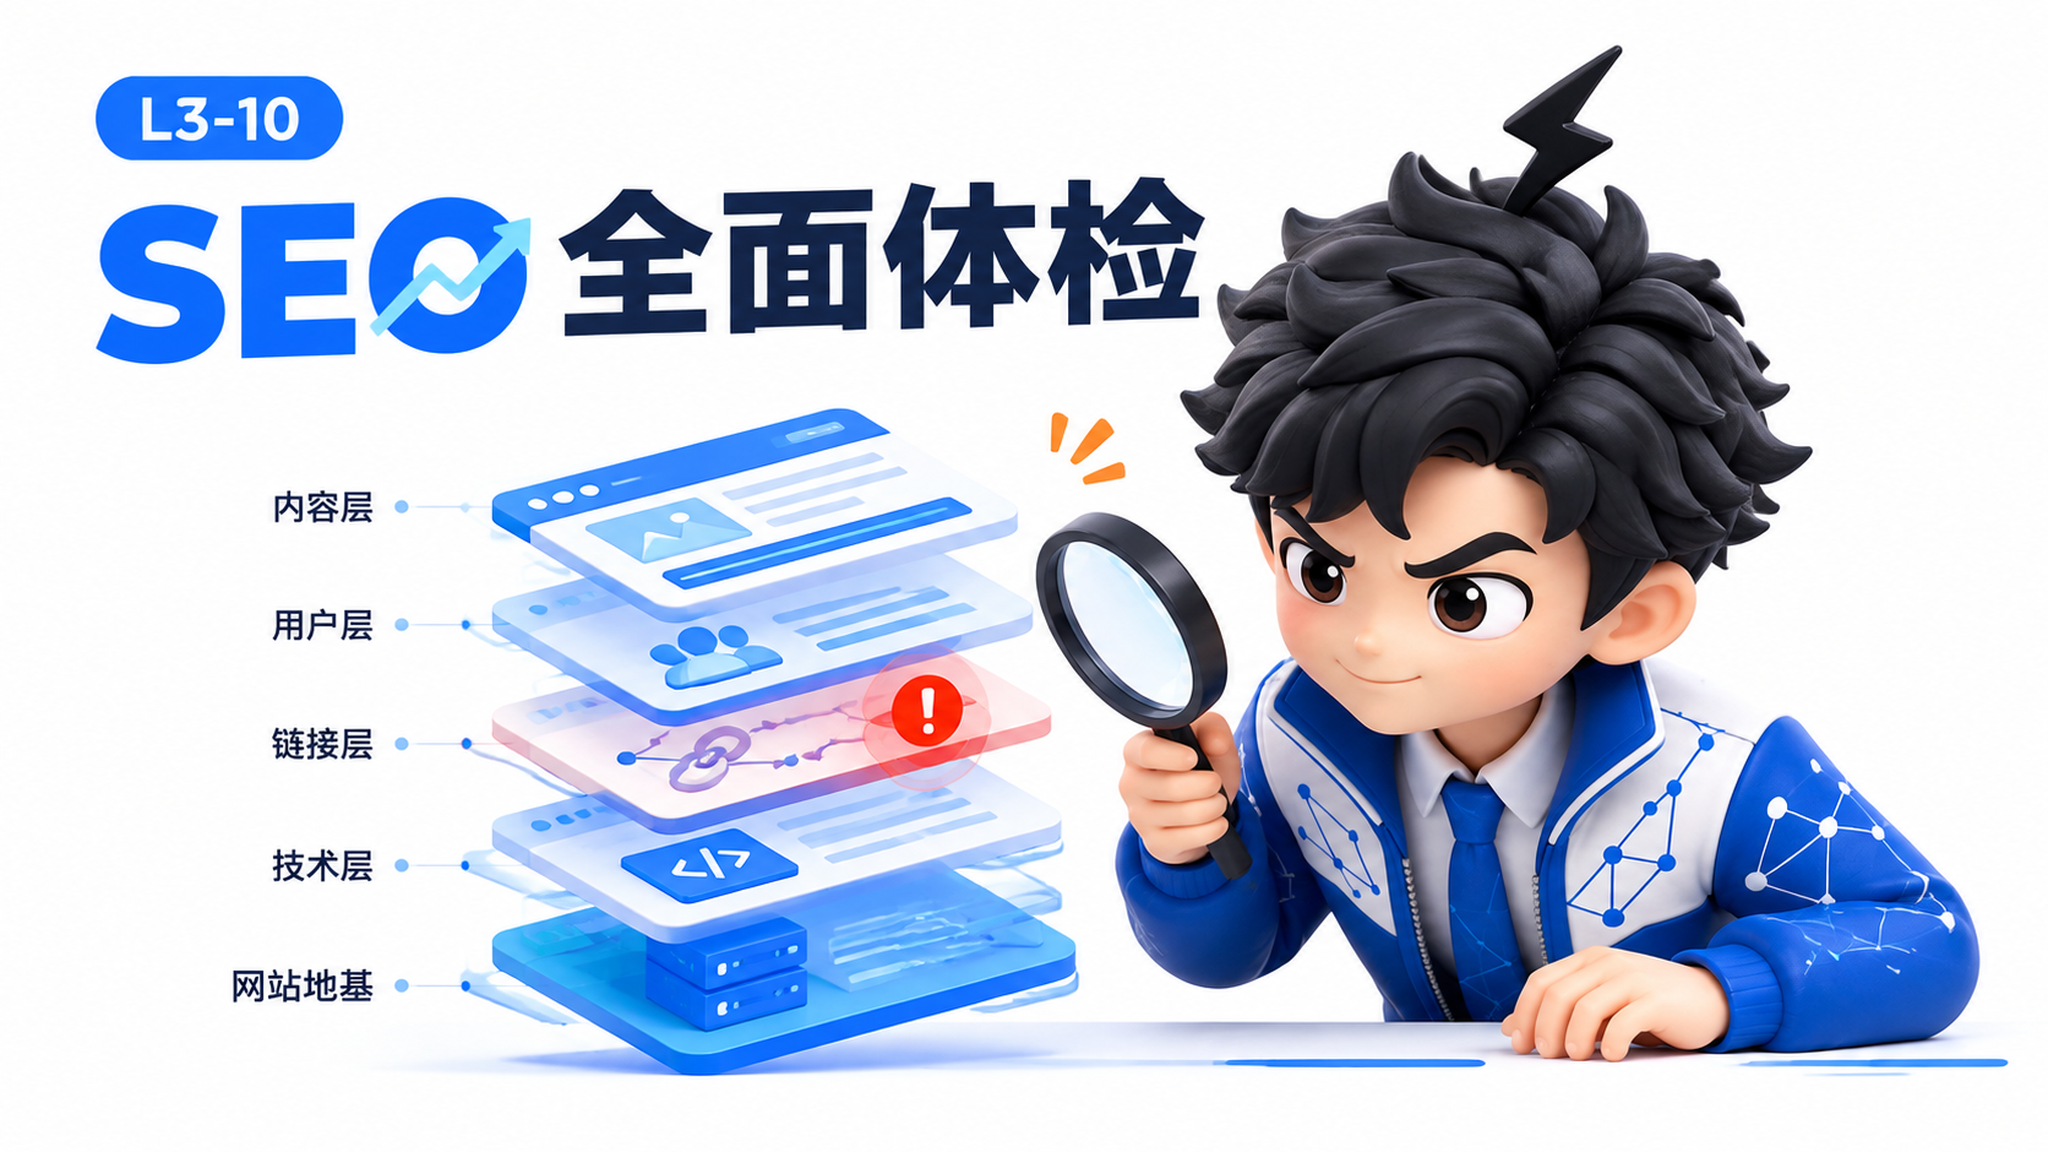
🎯 学什么:学会用五层金字塔从头到尾给网站做 SEO(SEO:搜索引擎优化) 系统体检——按优先级逐层排查,不瞎猜不乱找,每一层查出具体问题+修复方案。核心洞察:五层的顺序是铁律——网站连被 Google 索引都做不到(第一层),你花再多时间优化内容(第四层)也是白费。就像你写了一部伟大的小说,但出版社根本不知道你的存在。 💡 难易度:⭐⭐ | ⏱️ 预计时间:50 分钟
1. 课程概览
💡 白话小课堂:这个 Skill 就像一个大楼的安全检查员——一栋楼要验收,检查员不是东看一眼西看一眼,而是拿着一张五层清单:第一层看地基(网站能被 Google 找到吗),第二层看结构(网站快不快、手机能看吗),第三层看装修(标题写对了吗、页面有链接吗),第四层看内容(文章写得好不好),第五层看口碑(别的网站提到你了吗)。每一层过了才能去下一层——因为如果地基都不稳,装修再好看也会塌。
本课的独特定位——分层诊断型 Skill(与 L3-07 CRO(CRO:转化率优化)诊断对比):
| 特征 | L3-07(CRO 诊断) | L3-10(本课) |
|---|---|---|
| 诊断对象 | 单个页面的转化问题 | 整个网站的 SEO(SEO:搜索引擎优化)健康 |
| 层级数 | 6 维度 | 5 层金字塔 |
| 核心原则 | Clarity 优先级 | 可抓取性是最底层地基 |
| 输出 | 问题排序+修复方案 | 分层报告+优先级行动计划 |
🔑 核心秘诀:五层的顺序不能乱——因为每一层是上一层的前提。网站不能被索引 → 优化内容没有意义;网站移动端打不开 → 写再好的标题也没人看到。这是 SEO(SEO:搜索引擎优化)审计最容易被忽视的铁律——很多人在第四层(内容)花了 6 个月优化,但第一层(可抓取性)有个canonical(canonical:权威页面标签)标签错误,导致 600 页没被索引——6 个月白费。
⚠️ 避坑指南:Robots.txt 的"一个字符的灾难"——Disallow: / 后面多打了一个空格,或把 Disallow 写成了 Disalow(少了个 l),整站就被 Google 屏蔽了,排不上去还不知道为什么。一个字符,可能损失几万流量。
2. 五层审计金字塔详解
2.1 为什么顺序不能乱
每一层是上一层的"前提"——地基不牢,上层白做:

Layer 1: 可抓取性与索引(Crawlability & Indexation)
  → Google 能找到并索引你的页面吗?
  → 这是地基——一切的前提
  → 如果这一层失败:后面 4 层的所有优化都是空气

Layer 2: 技术基础(Technical Foundations)
  → 网站快吗?手机能看吗?URL 结构合理吗?
  → 这是结构——地基稳了,结构不能歪
  → 如果这一层失败:Google 能索引但用户体验差 → 排名掉

Layer 3: 页面优化(On-Page Optimization)
  → 标题标签、元描述、标题层级、内链正确吗?
  → 这是装修——结构好了,装修让人愿意进来
  → 如果这一层失败:排名有但 CTR(CTR:点击率)低 → 有人搜但没人点

Layer 4: 内容质量(Content Quality)
  → 内容值得排名吗?有深度吗?
  → 这是内核——装修好看,东西也要好
  → 如果这一层失败:点进来但秒关 → 高跳出率信号 → 排名掉

Layer 5: 权威与链接(Authority & Links)
  → 网站有可信度吗?别人提到你了吗?
  → 这是口碑——内核好,需要更多人知道
  → 如果这一层失败:排名稳定但冲不进前 3
2.2 每一层的检查清单
Layer 1: 可抓取性与索引
  □Robots.txt(Robots.txt:爬虫协议文件) 是否正确?(Disallow 别拼成 Disalow!)
  □XML(XML:可扩展标记语言)Sitemap(站点地图)是否提交到 Search Console(谷歌搜索控制台)?
  □ 用 site: 命令检查实际索引页数
  □ Canonical(Canonical:权威页面标签)标签是否正确?(最常见的错误:指向首页)
  □ 是否有孤儿页面(没有任何内链指向的页面)?
  □ 抓取预算是否被浪费在低价值页面上?

Layer 2: 技术基础
  □ Core Web Vitals(核心网页指标)(LCP(LCP:最大内容绘制时间)< 2.5s, INP(INP:交互响应时间)< 200ms, CLS(CLS:累积布局偏移)< 0.1)
  □ 移动端适配是否正常?
  □ HTTPS(HTTPS:加密网页传输协议)是否正确部署?
  □URL(URL:网页地址)结构是否清晰可读?(/blog/seo-audit 而非 /?p=123)
  □ 是否有 broken links(404 页面)?
  □ 页面加载速度(< 3 秒)

Layer 3: 页面优化
  □ 标题标签(< 60 字符)是否含核心关键词?
  □ 元描述(< 155 字符)是否吸引点击?
  □ 标题层级(H1 → H2 → H3)是否合理?
  □ 图片是否有 alt 文本 + 压缩?
  □ 内链结构是否合理?(Pillar → Cluster)
  □ URL slug 是否含关键词?

Layer 4: 内容质量
  □E-E-A-T(E-E-A-T:经验/专业/权威/信任 评估标准)信号(经验/专业/权威/信任)
  □ 内容深度:是否有原创数据/独特观点?
  □ 用户参与度:跳出率、停留时间、页面滚动深度
  □ 内容是否满足搜索意图?(用户搜了什么 vs 你给了什么)
  □ 是否有薄内容(< 300 字的页面)?

Layer 5: 权威与链接
  □ 外链数量和质量(多少个域名链向你?)
  □ 品牌提及(未链接的品牌名出现)
  □ 行业认可(媒体报道、行业奖项、专家引用)
  □ 竞品的外链差距(他们有什么链接你没有?)
2.3 最常见的致命错误
错误 1(Layer 1):Canonical(Canonical:权威页面标签)指向首页
  问题:600 个产品页的canonical(canonical:权威页面标签)标签 = 首页 URL
  后果:Google 认为这 600 个页面都是首页的复制品 → 不索引
  诊断:查看网页源代码搜索 "canonical",看值是什么
  修复:每个页面的canonical(canonical:权威页面标签)指向自己

错误 2(Layer 1):Robots.txt 拼写错误
  问题:Disallow 写成了 Disalow(少了个 l)
  后果:Google 不认识这个指令 → 当作"无限制"
       你想屏蔽的页面全部被索引
  诊断:在 Google Search Console(谷歌搜索控制台) 中验证 Robots.txt
  修复:更正拼写 → 重新提交

错误 3(Layer 2):移动端加载 5+ 秒
  问题:大量的未压缩图片、未使用的 JS、未优化的 CSS
  后果:Google 的移动优先索引 → 排名大幅下降
  诊断:PageSpeed Insights 或 Lighthouse
  修复:图片压缩 + 代码分割 + CDN

错误 4(Layer 4):内容太薄
  问题:产品描述只有 2 行
  后果:Google 判定为"低质量内容" → 不排名
  诊断:检查所有页面的字数统计
  修复:每页至少 300 字有效内容
3. 按网站类型的差异化诊断
不同网站类型有各自的"常见病"和检查重点:
SaaS 网站重点:
  → Layer 1: 检查功能页/博客/文档的索引状态
  → Layer 3: 标题标签含"产品功能+品类词"
  → Layer 4: 内容是否有对比页(vs 竞品)、集成页
  → Layer 5: 获取 G2/Capterra 等评测站的外链
  常见病:博客写了很多但产品页没排名

电商网站重点:
  → Layer 1: 产品变体(颜色/尺码)是否创建了重复页面?
  → Layer 3: 产品标题是否含品牌+品类+属性?
  → Layer 4: 产品描述是否足够详细(原创而非复制厂商文案)?
  → Layer 5: 获取产品评测/开箱视频的外链
  常见病:产品页canonical(canonical:权威页面标签)错误、描述太薄

内容网站重点:
  → Layer 1: 检查 Pillar-Cluster(支柱-集群 内容模型)是否都被索引
  → Layer 3: 内链是否从 Cluster 指向 Pillar?
  → Layer 4: 内容是否满足 E-E-A-T(E-E-A-T:经验/专业/权威/信任 评估标准)?(作者署名、引用来源)
  → Layer 5: 作为数据源被其他网站引用
  常见病:内容彼此孤立——没有内链网络

多语言网站重点:
  → Layer 1: Hreflang(Hreflang:多语言页面标记) 标签是否正确?(必须双向互链)
  → Layer 2: 不同语言版本的URL(URL:网页地址)结构
  → Layer 3: 每个语言版本的标题/描述是否独立优化
  常见病:Hreflang(Hreflang:多语言页面标记) 单向链接 → 谷歌忽略所有 hreflang
Hreflang(Hreflang:多语言页面标记) 的"必须双向确认"规则
Hreflang(Hreflang:多语言页面标记) 是告诉 Google"这个页面是英文版、那个是法文版"的标签。

铁律:双向互链(Reciprocal Links)
  → 英文页 A 声明"法文版是 B"
  → 法文页 B 也必须声明"英文版是 A"

如果只有 A→B 没有 B→A:
  → Google 认为"这两页可能不是同一内容的不同语言版本"
  → 所有hreflang(hreflang:多语言页面标记) 标签被忽略
  → 不同语言页面在搜索结果中互相竞争

这就像握手——单方面伸手不是握手,对方也必须伸手回应。
4. Schema 检测的坑——为什么不能直接 web_fetch
一个重要的实操陷阱:
问题:用 web_fetch 或 curl 检测页面的 Schema(Schema:数据结构化标记)标记

很多人这样做:
  curl https://example.com | grep "application/ld+json"
  发现:没有 Schema(Schema:数据结构化标记)!→ 结论:网站没有 Schema(Schema:数据结构化标记)

为什么错了?
  → web_fetch 和 curl 剥离了 <script> 标签
  → 无法看到 JavaScript 注入的 JSON-LD(JSON-LD:结构化数据格式)
  → 许多CMS(CMS:内容管理系统)插件(AIOSEO、Yoast、RankMath)通过客户端 JS 动态注入 Schema
  → 这些 Schema 在 HTML 源码中不可见

正确方法:
  1. 浏览器 DevTools 执行:
     document.querySelectorAll('script[type="application/ld+json"]')
  2. Google Rich Results Test(谷歌富媒体结果测试工具)(富媒体结果测试工具)(谷歌富媒体结果测试工具)
  3. Screaming Frog(SEO爬虫工具) 等能渲染 JavaScript 的工具
5. 结构拆解:分层诊断型 Skill 模板
分层诊断型 Skill 模板
核心特征
→ 诊断按层级优先级排序——下层是上层的前提 → 每一层有独立的检查清单 + 常见病 → 关键设计 = 层级不乱的铁律 + 按对象类型的差异化诊断 → 输出 = 分层报告(每层的发现+优先级修复方案)
通用结构
Diagnostic Pyramid(诊断金字塔)
Layer 1: [地基层] — 检查清单 — 常见致命错误 Layer 2: [结构层] — 检查清单 — 常见致命错误 ... Layer N: [表层层] — 检查清单 — 常见致命错误
Object-Type Profiles(对象类型差异化)
Type A: [网站类型] — 重点检查层 — 常见病 Type B: [网站类型] — ...
Report Format(报告格式)
- 执行摘要(最关键发现 + 优先级)
- 技术发现(Layer 1-2)
- 页面发现(Layer 3-4)
- 权威发现(Layer 5)
- 优先级行动计划(按紧急度排序)
与 L3-07(CRO 诊断)的关系:两者都是分层诊断型,但诊断对象不同——L3-07 诊断单页面的转化问题,L3-10 诊断全站的 SEO(SEO:搜索引擎优化)健康。结构复用:都是"先分入口条件 → 再分层诊断"。 与 L3-12(Schema(Schema:数据结构化标记)标记)的关系:L3-10 在 Layer 1 和 3 中会检查 Schema,L3-12 是专门深入 Schema(Schema:数据结构化标记)的完整方法论。
6. 电商案例:家居灯具独立站 800 个产品页的五层 SEO(SEO:搜索引擎优化)审计
🛒 实战案例:「光舍」原创家居灯具品牌在 Shopify 建的独立站有 800+ 产品 SKU(SKU:库存单位)(吊灯/落地灯/台灯/壁灯),运营 14 个月投入了大量精力做内容——写了 120 篇灯具选购博客。但 Google 自然搜索流量每月仅约 650 UV,博客平均排名在 3-5 页。团队一直在第四层(内容质量)努力——"是不是博客写得不够好?要不要加更多图片?"花了 8 个月写内容、优化产品描述,流量纹丝不动。
用 SEO Audit 五层金字塔逐层诊断:
Layer 1 发现(致命——之前从未检查过):
- Robots.txt:正常 ✓ -XML(XML:可扩展标记语言)Sitemap:已提交到 Search Console(谷歌搜索控制台) ✓
- site:light-house.com → 仅 214 条结果(800 个产品页 + 120 篇博客 = 应有 920+)
- 根因:600 个产品页的canonical(canonical:权威页面标签)标签统一指向首页
/——等于告诉 Google"我这 600 个页面都是首页的复制品,不用索引"- 120 篇博客 canonical 正确指向自身,所以博客能正常索引——但产品页大量缺失
Layer 2 发现:
- Core Web Vitals(核心网页指标):桌面端 LCP 1.8s ✓,移动端 LCP 4.7s ✗(图片未压缩,产品图均为 3-5MB PNG)
- 移动端适配:布局正常但加载太慢
Layer 3 发现:
- 产品标题均为"光舍 | 产品型号"(如"光舍 | LD-2201")——不含任何品类词,Google 不知道这是吊灯
- 博客之间的内链为零——120 篇文章互相没有链接,Pillar-Cluster(支柱-集群 内容模型)体系缺失
Layer 4 发现:
- 产品描述 80% 是复制供应商文案("简约现代风格,适合客厅卧室"),薄内容严重
- 但博客质量不错——部分文章有原创数据和安装教程
Layer 5 发现:
- 外链:仅 3 个域名(供应商官网、品牌 LinkedIn 页、一篇本地媒体采访)
- 竞品分析:排名前 3 的竞品有 40-80 个引用域名,主要来自家居设计博客+评测站
修复方案(按层级优先级):
- Layer 1(修复 24 小时内上线):修正 600 个产品页 canonical 为各自真实 URL
- Layer 2(1 周内):图片批量压缩为 WebP + CDN(CDN:内容分发网络)开启,移动端 LCP 目标 < 2.5s
- Layer 3(2 周内):产品标题改为"[品类词] [风格] [型号] —— 光舍"(如"北欧风三头吊灯 LD-2201 —— 光舍")
- Layer 3-4(1 个月内):为博客建立 3 个 Pillar 体系 + 补写产品描述至每款 150-200 字原创文案
- Layer 5(3-6 个月计划):联系家居设计博客投稿+在 Houzz/Pinterest 建立引用点
效果:
- 修复后 30 天:Google 索引页数从 214 → 780+,月自然搜索流量从 650 → 5,800 UV(+792%)
- 修复后 60 天:流量稳定在 7,200-8,500 UV,产品标题优化后 CTR(CTR:点击率)从 1.8% → 3.4%
- 关键认知:8 个月在 Layer 4(内容质量)的努力完全白费——因为 Layer 1 的canonical(canonical:权威页面标签)错误让 600 个页面根本没有被索引
🔑 启示:SEO 五层金字塔的优先级顺序是用教训换来的。8 个月的内容优化全部白费——不是因为内容写得不好,是因为 Google 根本没看到这 600 个页面。先查地基(Layer 1 可抓取性),再装修(Layer 3-4)。一个canonical(canonical:权威页面标签)标签错误 = 8 个月的内容团队投入归零。
7. 掌握检验
Q1:SEO 五层审计金字塔的正确顺序是:
- A) 内容质量 → 页面优化 → 权威链接 → 可抓取性 → 技术基础
- B) 可抓取性与索引 → 技术基础 → 页面优化 → 内容质量 → 权威与链接
- C) 技术基础 → 可抓取性 → 内容质量 → 页面优化 → 权威链接
- D) 权威链接 → 内容质量 → 页面优化 → 技术基础 → 可抓取性
Q2:一个植物电商网站有 800 个产品页,但 Google 只索引了约 200 个。以下哪个最可能是根本原因?
- A) 网站加载速度太慢
- B) 产品描述内容太薄(只有 5 行)
- C) Canonical(Canonical:权威页面标签)标签错误地指向了首页
- D) 外链太少(只有 3 个)
Q3:为什么不能直接用 web_fetch 或 curl 检测网页的 Schema(Schema:数据结构化标记) 结构化数据?正确的检测方法是什么?
Q4:Hreflang(Hreflang:多语言页面标记) 标签中,为什么双向互链(A 指向 B 则 B 必须指回 A)是一个硬性要求?如果只有单向链接,会发生什么?
Q5:一个网站做了 6 个月的 SEO(SEO:搜索引擎优化)优化,一直在改进内容质量(第四层),但流量没有明显增长。请用五层审计逻辑诊断:他们最可能忽略了什么?应该从哪一层开始复查?
Q6:请将以下 SEO 问题归类到正确的审计层级: (1)Robots.txt(Robots.txt:爬虫协议文件) 把 Disallow 写成了 Disalow (2) 移动端加载 2.8 秒 (3) 产品标题是"产品名 - 店铺名"格式 (4) 产品描述只有 2 行字 (5) 网站只有供应商的 3 个外链
Q7:Robots.txt(Robots.txt:爬虫协议文件)中一个字符的错误可能导致的后果是什么?如何预防?
8. 答案
点击查看答案
Q1:B —— 顺序不能乱:可抓取性与索引 → 技术基础 → 页面优化 → 内容质量 → 权威与链接。如果页面不能被索引(Layer 1),优化标题和内容(Layer 3、4)是白费力气。
Q2:C —— Canonical(Canonical:权威页面标签)标签错误指向首页是最可能的根因。600 个产品页的canonical(canonical:权威页面标签)指向首页 = 告诉 Google"这 600 个页面都是首页的复制品,不用索引"。这是第一层问题,先于内容质量(B)和技术基础(A)。
Q3:参考答案——web_fetch 和 curl 剥离了 <script> 标签,无法看到 JS 注入的 JSON-LD(JSON-LD:结构化数据格式)。正确方法:(1) 浏览器 DevTools 执行 document.querySelectorAll('script[type="application/ld+json"]');(2) Google Rich Results Test(谷歌富媒体结果测试工具)(富媒体结果测试工具)(谷歌富媒体结果测试工具);(3) Screaming Frog(SEO爬虫工具) 等能渲染 JS 的工具。
Q4:参考答案——Hreflang(Hreflang:多语言页面标记) 要求双向互链。如果只有单向,Google 会认为"这两页可能不是同一内容的不同语言版本"→双向配对都被忽略→所有hreflang(hreflang:多语言页面标记) 标签失效。就像握手——单方面伸手不是握手。
Q5:参考答案——最可能忽略了 Layer 1(可抓取性与索引)或 Layer 2(技术基础)。如果Robots.txt(Robots.txt:爬虫协议文件) 屏蔽、Sitemap 未提交、canonical 错误,在 Layer 4 花再多时间都是"在废墟上装修"。应从 Layer 1 复查:Robots.txt 正常?Sitemap 提交?canonical 正确?用 site: 检查实际索引页数。
Q6:参考答案——(1) Layer 1;(2) Layer 2;(3) Layer 3;(4) Layer 4;(5) Layer 5。
Q7:参考答案——Disallow 少打一个 l→Disalow,搜索引擎不认识→当作"无限制"→本想保护的页面被随意抓取;或 Disallow: / 写成 Disalow: /→整站屏蔽失效。预防:每次修改后在 Search Console 验证。
评分:答对 5/7 = 通过。
9. 延伸阅读
- [[L3-11-AI时代SEO|下一课:AI 时代 SEO]] — 从"排名"到"被 AI 引用"
- [[L3-12-Schema结构化标记|L3-12:Schema(Schema:数据结构化标记)标记]] — Layer 1 和 Layer 3 的 Schema(Schema:数据结构化标记) 方法论
- [[L3-07-页面转化率优化|L3-07:CRO 诊断]] — 回顾分层诊断模式
评论区
共 0 条评论